


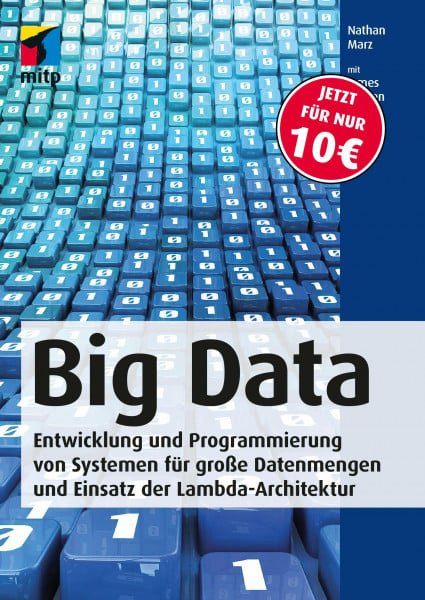
Big Data: Entwicklung und Programmierung von Systemen für große Datenmengen und Einsatz der Lambda-Architektur (mitp Professional)
Kurzinformation
 Handgeprüfte Gebrauchtware
 Schnelle Lieferung
 Faire Preise
inkl. MwSt. Versandinformationen
Lieferzeit 1-3 Werktage
Lieferzeit 1-3 Werktage

Beschreibung
Einführung in Big-Data-Systeme und -Technologien Große Datenmengen speichern und verarbeiten Einsatz zahlreicher Tools wie Hadoop, Apache Cassandra, Apache Storm uvm. Daten müssen mittlerweile von den meisten Unternehmen in irgendeiner Form verarbeitet werden. Dabei können sehr schnell so große Datenmengen entstehen, dass herkömmliche Datenbanksysteme nicht mehr ausreichen. Big-Data-Systeme erfordern Architekturen, die in der Lage sind, Datenmengen nahezu beliebigen Umfangs zu speichern und zu verarbeiten. Dies bringt grundlegende Anforderungen mit sich, mit denen viele Entwickler noch nicht vertraut sind. Die Autoren erläutern die Einrichtung solcher Datenhaltungssysteme anhand eines speziell für große Datenmengen ausgelegten Frameworks: der Lambda-Architektur. Hierbei handelt es sich um einen skalierbaren, leicht verständlichen Ansatz, der auch von kleinen Teams implementiert und langfristig betrieben werden kann. Die Grundlagen von Big-Data-Systemen werden anhand eines realistischen Beispiels praktisch umgesetzt. In diesem Kontext lernen Sie neben einem allgemeinen Framework zur Verarbeitung großer Datenmengen auch Technologien wie Hadoop, Storm und NoSQL-Datenbanken kennen. Dieses Buch setzt keinerlei Vorkenntnisse über Tools zur Datenanalyse oder NoSQL voraus, grundlegende Erfahrungen im Umgang mit herkömmlichen Datenbanken sind aber durchaus hilfreich. Aus dem Inhalt: Big-Data-Systeme und -Technologien Echtzeitverarbeitung sehr großer Datenmengen Lambda-Architektur Batch-Layer: Datenmodell, Datenspeicherung, Skalierbarkeit Stapelverarbeitungsprozesse Modellierung von Stammdatensätzen Implementierung eines Graphenschemas mit Apache Thrift Einsatz von MapReduce JCascalog zur Implementierung von Pipe-Diagrammen Serving-Layer: Konzepte und Einsatz von ElephantDB Speed-Layer: Berechnung und Speicherung von Echtzeit-Views Einsatz von Hadoop, Apache Cassandra, Apache Kafka und Apache Storm Streamverarbeitung mit Trident
Produktdetails

So garantieren wir Dir zu jeder Zeit Premiumqualität.


